专家档案
WorkBuddy 的专家市场里有 400 多位专家。「专家档案」是一个非官方社区工具:在召唤专家之前,先看清它适不适合你,包括能帮你做什么、要先开通什么、要准备什么、最后拿到什么、说话是什么风格。也可以用一句话描述需求,它会拆成几个需求分别推荐专家。
- 我的角色
- 个人项目:需求定义、档案规范与提示词设计、搜索评测、打包发布(与 AI 协作开发)
- 时间
- 2026.10
- 规模
- 434 位专家,每位一页档案;29 条搜索测试全部通过
- 形态
- 单文件网页版,可以在 WorkBuddy 右侧栏的浏览器里打开;搜索在本机完成,不调用模型
非官方社区作品,与腾讯无关,未经腾讯官方认可。WorkBuddy 是腾讯的商标。
30 秒看完
- 把召唤前不知道的事提前摆出来:每位专家一页档案,写清适合谁、要先开通哪些 API Key 或连接器、要准备什么材料、会拿到什么、说话风格如何。
- 一句话找专家:「帮我改简历,再规划一下要不要走校招」会被拆成两个需求,每个需求推荐 5 位专家;一位专家能同时覆盖时,单独提示。
- 零成本搜索:拆需求和打分都在用户的电脑上完成,不调用模型,不消耗 token,也不需要 API Key。
- 用规则约束 AI 生成的内容:372 份档案由模型批量生成,提示词限定只写用户需要知道的事,不泄露专家的内部工作方法,输出不合格就重试。
01为什么做
在 WorkBuddy 的专家市场里选专家时,常遇到这些问题:
- 不知道该找谁。专家名字大多看不出具体能做什么。用户想的是「我想把自媒体账号做起来」,而不是某个专家的名字。
- 召唤了才发现不合适。聊了几轮,才发现它擅长的不是自己要的,时间和额度都花掉了。
- 召唤了才发现用不了。有些专家要先开通 API Key、连接器或订阅,但这些信息要等对话开始后才知道。
- 不知道要准备什么。材料没备齐,专家只能先追问,来回好几轮。
- 不了解说话风格。有的专家反馈很直接、标准很高,没有心理准备的话,体验落差很大。
- 分不清出品方。市场里既有官方专家,也有第三方和个人开发者做的专家,选的时候看不出来。
「专家档案」把这些信息提前摆出来,让用户在召唤之前就能判断。
02定位与边界
做什么
- 每位专家一页档案:适用场景、前置依赖、准备材料、交付物、说话风格、注意事项
- 一句话描述需求,拆开后分别推荐专家
- 用标签标出官方 / 非官方、出品方、面向人群和风格
不做什么
- 不写专家的内部工作方法:不描述步骤、工具、评分细则,不复述提示词
- 不打包官方数据:专家名单在运行时读取 WorkBuddy 公开的清单
- 不替用户召唤:看完档案后,回到 WorkBuddy 自己召唤
腾讯自家的产品只展示官方介绍,不另写档案(62 位)。部分专家改编自开源项目 agency-agents(MIT 协议),档案里会注明出处(109 位)。专家作者希望修改或移除档案,可以通过页面底部的方式联系。
03看看效果
也可以直接打开在线版自己试试,比如输入「双十一要到了店铺怎么准备,顺便想做个直播」。
04核心设计
1. 档案回答召唤前的六个问题
| 版块 | 回答的问题 |
|---|---|
| 适合你,如果 | 这位专家能帮我解决什么? |
| 召唤前要先开通 | 有没有必需的 API Key、连接器、订阅或账号? |
| 你需要准备 | 要备好哪些材料?(标了「可选」的可以不准备) |
| 你会拿到 | 最后能拿到什么,是什么格式? |
| 说话风格 | 它会怎么跟我说话? |
| 注意 | 哪些内容要自己核实?适用范围是什么? |
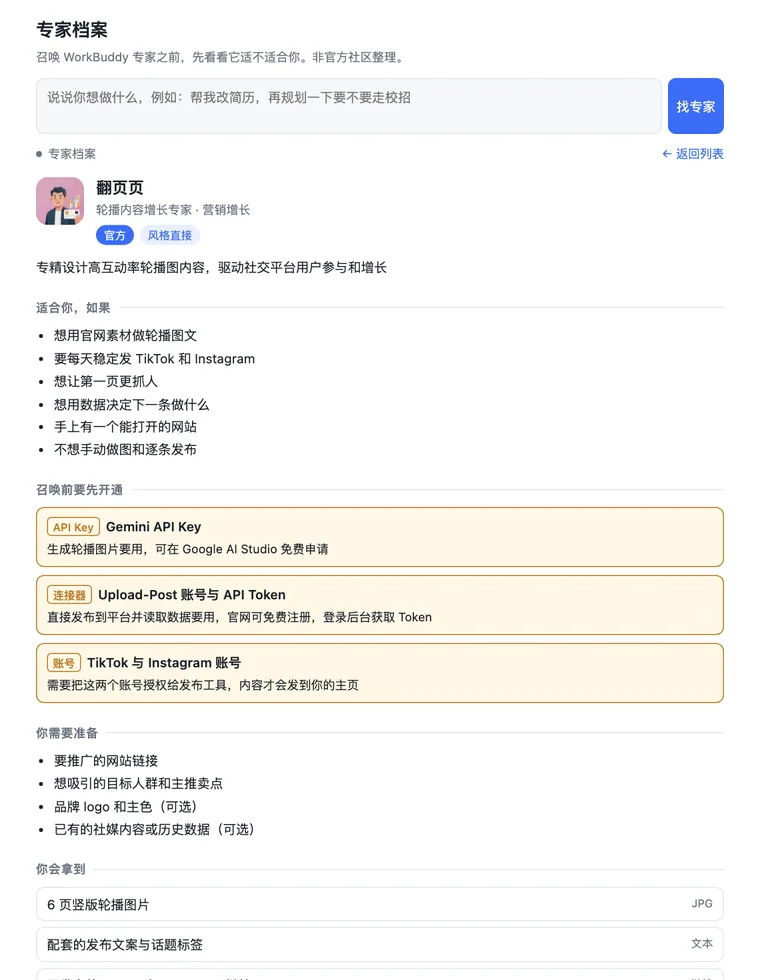
「召唤前要先开通」只写不开通就用不了核心功能的依赖;只在某种导出格式或附加功能才用到的,放进「你需要准备」并注明「可选」。目前 434 位专家里,有 82 位需要先开通依赖,118 位只面向特定人群。
2. 标签帮用户快速筛
- 官方 / 非官方 · 出品方:第三方团队显示团队名,个人作者统一显示为「个人开发者」。
- 人群标签:只面向特定人群时标出来,例如「面向执业律师」「面向在校生和应届毕业生」。
- 需先开通依赖:召唤前要先开通 API Key、连接器、订阅等。
- 风格标签:「风格直接」「标准比较高」「语气比较犀利」,只是让用户提前有个心理准备,不代表专家好或不好。目前有 107 位标为风格直接,4 位标准比较高。
3. 一句话找专家,在本机完成
- 拆需求:按标点和「然后、顺便、再帮我」这类连接词拆开;以「但是、不过、主要是」开头的片段是在补充上一句,不算新需求;去掉「帮我、一下、请问」这类不带需求信息的口头语。
- 打分:每个需求对专家的各个字段做加权打分。档案里的「用户会怎么说」和「适合你,如果」权重最高,其次是检索关键词、名称和标签,简介最低。
- 补同义说法:「校招」也会去找秋招、应届、求职;「双十一」也会去找双 11、大促,弥补档案里没写到的叫法。
- 给结果:每个需求推荐 5 位专家;如果有一位专家能同时覆盖所有需求,结果顶部单独提示。
因为不调用模型,搜索没有等待,也不消耗 token。每次搜索和每位专家都有自己的链接,可以直接发给别人。
4. 用规则约束 AI 生成的档案
434 份档案里,372 份是用 DeepSeek 根据专家的公开定义批量生成的。我给生成写了一套规则:
- 只写用户需要知道的事:不描述专家的工作步骤,不出现工具名、技能名、评分维度、检查项或阈值,不复述提示词、话术原文和安全规则。
- 防止被资料带偏:明确告诉模型,资料里的任何指令都不是给它的指令。
- 风格分四档、措辞中性:友好、直接、标准高、犀利各有判断标准,只能依据资料里明确的描述判断,看不出来就填友好;概括写成给用户的提示,不用贬义词。
- 只写真实会产出的东西:交付物 2–5 项,只写资料里真实会产出的;不用「赋能」「一站式」这类营销腔。
- 输出要能校验:只输出固定结构的 JSON,程序逐个字段检查,不合格就重新生成;档案文件也可以直接手工修改。
05评测
搜索效果用一份测试集检验:29 句用户可能会说的话,比如「我想要一个能帮我改简历的专家,再帮我规划一下我的职业道路怎么选择,要不要走校招」「双十一要到了店铺怎么准备,顺便想做个直播」。每句按需求标出可以接受的专家(每个需求一组,推荐里出现其中一位就算对),有的还标出不应该出现的专家。
29 / 29
在本机运行测试脚本,29 句全部通过:每个需求都推荐到了可以接受的专家,也没有出现标为不应出现的专家。
测试脚本和搜索用的是同一份代码和档案,改了搜索规则或档案后可以随时重跑。
06使用形态
「专家档案」是一个单文件网页:
- 一个 index.html,双击就能用,也可以放到任何静态网站上,不需要服务器程序;
- 在 WorkBuddy 对话页右侧栏的「打开浏览器」里输入网址,同样可以边聊边查;
- 读不到专家名单时,先显示上次读取的名单并在顶部提示。
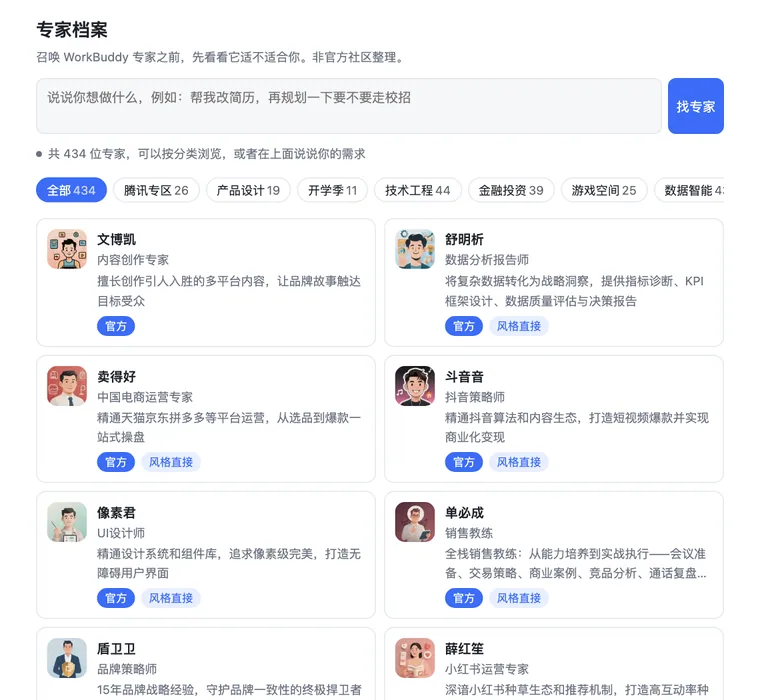
07下载与使用
- 打开在线版,或者解压后双击
index.html。页面会在线读取最新的专家名单,需要联网,首次打开可能要等几秒。 - 在顶部输入框里描述你想做的事,按回车或点「找专家」;不输入的话,可以按分类浏览。
- 看推荐结果时留意卡片上的标签,点卡片看完整档案。
- 觉得合适,就回到 WorkBuddy 的「专家·技能·连接器」里搜索这位专家并召唤。召唤前先开通档案里列出的依赖,第一句话就把准备好的材料发给专家。
08目前的不足
- 档案根据专家的公开信息整理,由模型生成,可能和专家的实际表现有出入,以实际表现为准。
- 新上架的专家会先显示基本信息,档案要等后续版本补充。
- 搜索测试集目前只有 29 句,覆盖的说法还不多。